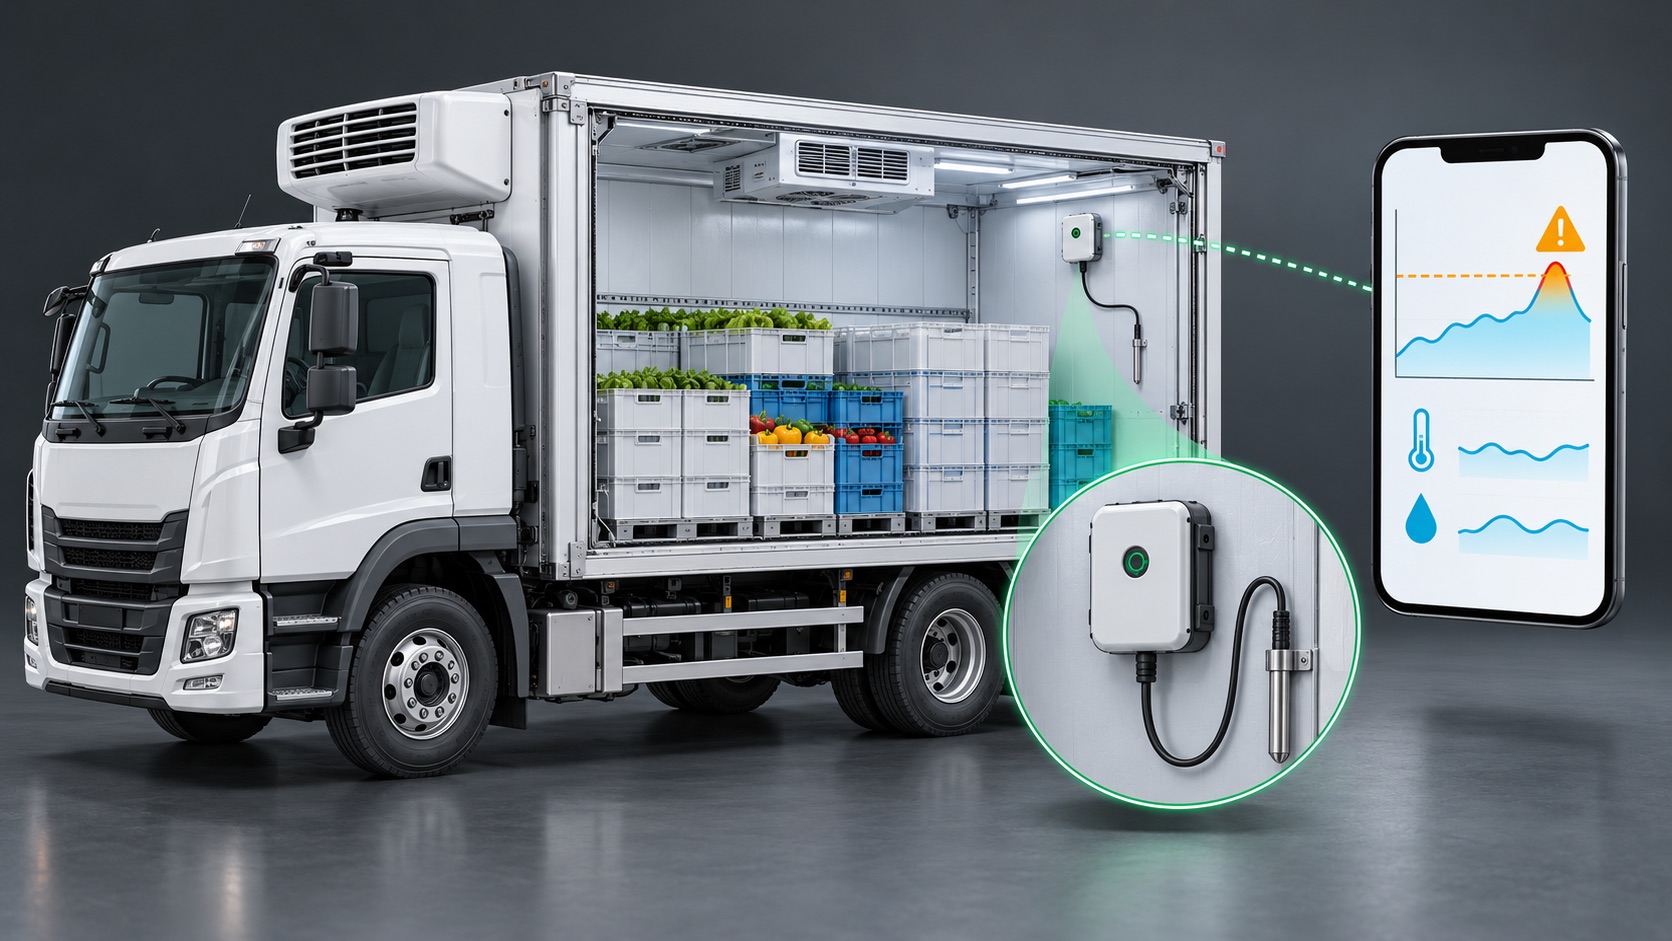
一辆冷藏车在运输途中出现温度异常,运营人员真正需要知道的,不只是“现在多少度”,还包括异常从何时开始、持续了多久,以及是否已经有人处理。
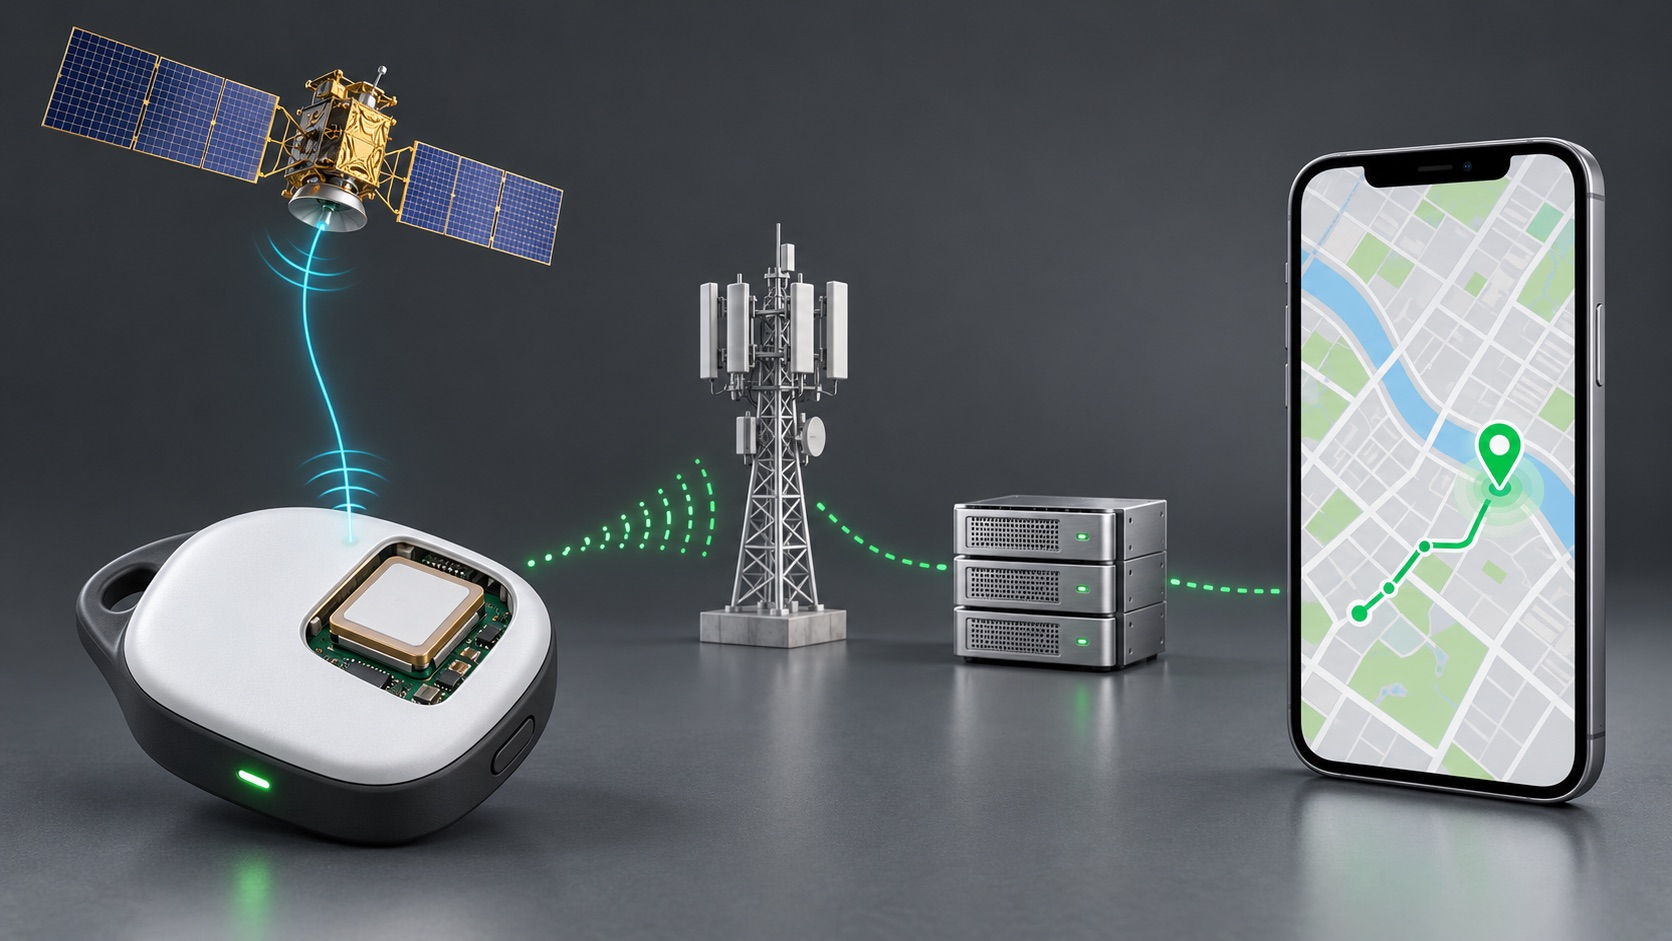
因此,冷链监测不能只围绕传感器选型展开。一个完整的设计,需要把测量、记录、传输和告警处理连接起来。下面沿着一条温湿度数据的路径,说明每个环节要解决什么问题。
第一步:明确测什么、在哪里测
测量对象决定了数据的含义。车厢空气温度、货物表面温度和包装内部温度,分别反映不同的状态,不能直接相互替代。项目开始时,应先明确要监测哪一种状态,再决定探头类型、数量和安装位置。
例如,出风口附近与车门附近的读数可能不同。单个探头只能反映其所在位置,是否需要多个测点,应结合车厢结构、装载方式和实际运输要求验证。
器件选择是在此基础上的下一步。以 Sensirion SHT40 为例,它可以采集温度和相对湿度;但元件规格并不等于整机安装后的表现。外壳通风、安装位置和探头响应,都需要一起评估。
第二步:把测量变成可追溯的记录
拿到一个读数之后,还要回答“这是哪个探头、在什么时间测得的”。建议每条记录带上设备标识、探头标识、采集时间和有效性状态,便于平台还原过程,也便于识别探头故障。
这里需要区分三个容易混淆的动作:
| 动作 | 解决的问题 | 设计时需要确定 |
|---|---|---|
| 采样 | 多久测量一次 | 希望识别多短的温湿度变化 |
| 记录 | 哪些数据需要留下 | 保存频率、容量与掉电保护 |
| 上报 | 何时把数据送到平台 | 日常发送间隔与异常发送策略 |
三者不必使用同一个频率。可以按业务需要持续采集、定期上传,并在识别到异常时尝试及时上报。具体间隔应由可接受的发现延迟、存储和供电条件决定,而不是套用一个固定数值。
第三步:让断网成为延迟,而不是数据空白
即使设备使用 4G,也需要考虑途中暂时无法联网的情况。合理的目标是:通信中断时,设备仍按既定策略测量和记录;连接恢复后,再补传尚未上传的数据。
平台应按采集时间整理补传记录,并将历史异常与当前状态区分开。否则,一条刚收到的旧记录,可能被误认为刚刚发生的超温事件。
缓存也有边界。设计时应明确最长离线时间、缓存满后的处理方式,以及掉电后能否保留记录。这些约定决定了“可追溯”在什么条件下成立。
第四步:从异常判断走到人员处置
数据到达平台,并不代表异常已经得到处理。告警应进一步回答四个问题:什么情况下触发、通知谁、如何确认,以及何时关闭。
例如,开门装卸造成的短时变化,与持续制冷异常可能需要不同的处理规则。但是否允许延时、延时多久,必须依据货物和运营要求确定,不能为了减少通知而随意忽略波动。
建议分别定义超温、探头断开和设备离线等事件,并记录触发、接收、处理与恢复状态。需要断网期间现场提醒的项目,还应评估设备本地告警,而不是完全依赖云端。
最后:用一次完整异常验证整个系统
验收时,可以模拟“读数异常 → 网络中断 → 本地记录 → 恢复补传 → 人员确认”的完整过程,逐项核对数据和处理状态是否符合预期,再补充探头断开、供电中断等测试。
冷链监测的关键,是让一条数据既有可信的来源,也有连续的记录和明确的处理去向。它可以帮助发现问题、还原过程,但不能仅凭监测记录就认定货物质量合格。具体测点、告警规则和验收条件,仍需结合项目要求确定。